Un mardi soir, vous devez résumer un contrat de travail et préférez ne pas le coller dans ChatGPT. C’est souvent ainsi que naît l’idée d’installer une IA en local sur PC. Avec Ollama ou LM Studio, deux logiciels gratuits, un modèle de langage tourne directement sur votre ordinateur. Reste à savoir si votre ordinateur est à la hauteur ou quelle machine acheter.
Pourquoi faire tourner une IA sur son propre PC
Le premier argument est la confidentialité. Avec un assistant cloud comme ChatGPT, Claude ou Gemini, chaque question posée et chaque document envoyé sont transmis aux serveurs de l’éditeur. Un modèle local traite vos données directement sur votre ordinateur, sans les transmettre à un serveur distant. Pour des documents médicaux, des contrats ou du code d’entreprise, ce point justifie à lui seul l’installation.
Viennent ensuite le coût et l’indépendance vis-à-vis de la connexion. Les abonnements payants des assistants en ligne se règlent chaque mois, alors qu’une fois le matériel acquis, un modèle local ne coûte que l’électricité consommée. Une fois téléchargé, le modèle fonctionne sans connexion Internet, dans un train comme sur un réseau d’entreprise filtré.
Ollama, logiciel open source, s’installe sous Windows, macOS et Linux et se pilote en ligne de commande (ollama run suivi du nom du modèle) ou via une interface. LM Studio est une application avec interface complète, qui permet de télécharger les modèles depuis Hugging Face. Depuis juillet 2025, son usage est gratuit, y compris au travail. Jan et GPT4All, deux autres outils open source, fonctionnent sur le même principe. Tous donnent accès aux modèles ouverts les plus connus : Llama de Meta, Gemma de Google, Mistral, Qwen ou gpt-oss d’OpenAI.
Les critères matériels pour une IA en local sur PC
La taille d’un modèle se mesure en milliards de paramètres (7B, 13B, 70B). Pour faire tenir le modèle dans une machine grand public, on utilise la quantification : chaque paramètre est stocké avec moins de précision numérique, souvent sur 4 bits, dans un fichier au format GGUF lu par llama.cpp, le moteur utilisé par Ollama et LM Studio. Une version quantifiée de Llama 3.1 8B pèse ainsi 4,9 Go dans la bibliothèque d’Ollama.
La mémoire vidéo (VRAM) de la carte graphique est le critère numéro un. Tant que le modèle tient entièrement dans la VRAM, les réponses s’affichent vite. S’il déborde, une partie du modèle est chargée en RAM et traitée par le processeur. La vitesse chute alors fortement. La commande ollama ps indique la répartition : 100% GPU est bon signe ; un partage entre le processeur et la carte graphique explique la lenteur. Pour comparer les configurations selon ces critères, un comparatif détaille comment faire tourner un LLM en local sur une configuration Nvidia, un Mac ou un mini-PC.
La RAM sert de filet de sécurité. Ollama recommande au moins 8 Go pour un modèle de 7 milliards de paramètres, 16 Go pour 13 milliards et 64 Go pour 70 milliards. La VRAM fixe aussi la longueur du contexte, c’est-à-dire la quantité de texte que le modèle garde en mémoire. Ollama règle par défaut le contexte à 4 000 tokens avec moins de 24 Go de VRAM, à 32 000 tokens entre 24 et 48 Go et à 256 000 tokens au-delà.
Le processeur passe après. Sur un PC sans GPU dédié, un petit modèle de 3 à 4 milliards de paramètres fonctionne sur le CPU, avec des réponses nettement plus lentes. Le stockage compte au chargement : un modèle de 15 Go se charge beaucoup plus vite sur un SSD NVMe, comme l’explique l’article SSD NVMe ou SATA.
Les trois grandes familles de configurations
Le PC avec carte graphique Nvidia
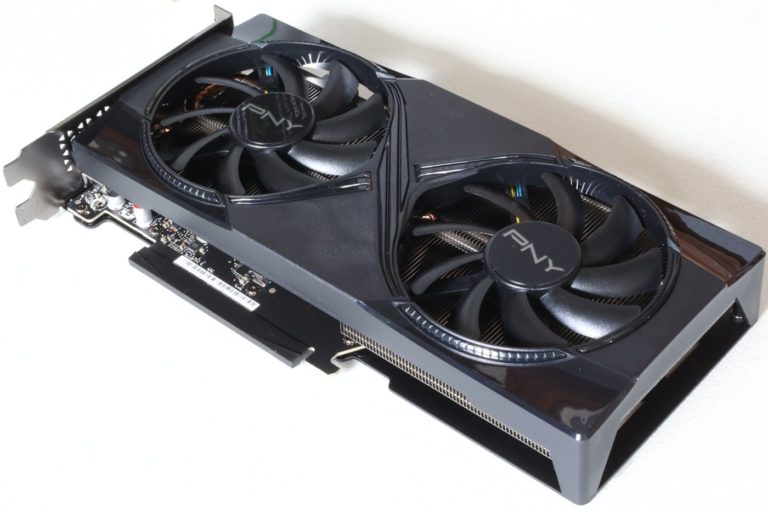
C’est la configuration la plus répandue. Elle est aussi la mieux prise en charge par les logiciels, grâce à la technologie CUDA de Nvidia. Une carte de 8 Go, comme la GeForce RTX 4060, fait tourner les modèles de 7 à 8 milliards de paramètres. La RTX 5060 Ti existe en version 16 Go de GDDR7, de quoi charger gpt-oss-20b, présenté par OpenAI en août 2025 comme capable de fonctionner avec 16 Go de mémoire. Au sommet, la RTX 5090 offre 32 Go de VRAM. La vitesse de génération dépend surtout de la bande passante de la mémoire. Nvidia indique 448 Go/s pour la RTX 5060 Ti, contre 272 Go/s pour la RTX 4060.
Le Mac avec puce Apple
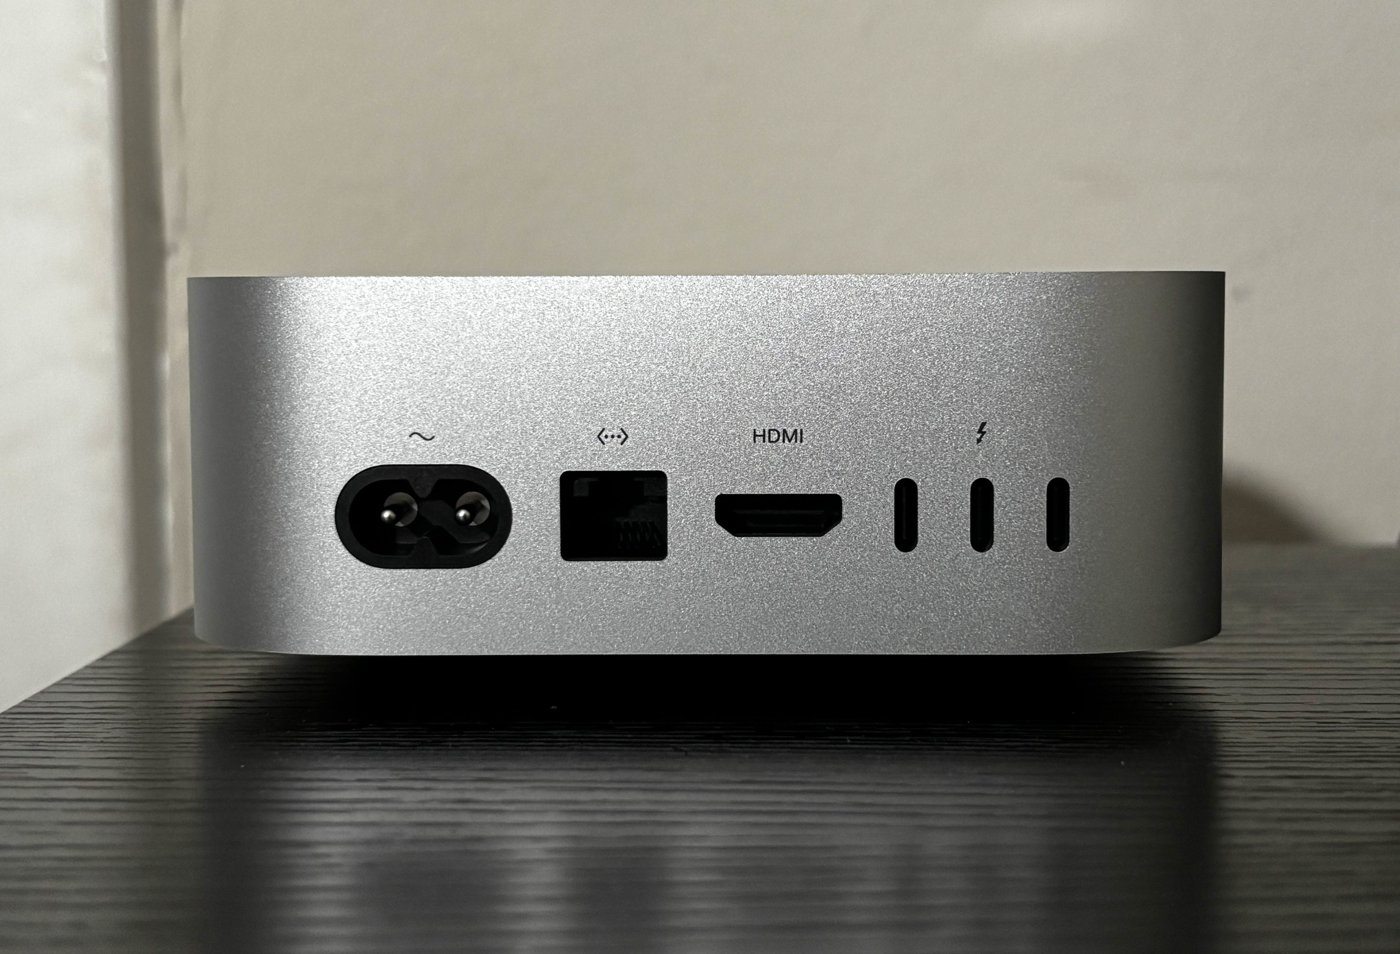
Sur un Mac à puce Apple Silicon, la mémoire unifiée est partagée entre le CPU et le GPU. Un Mac de 32 Go peut donc consacrer une grande partie de cette mémoire au modèle, là où un PC est limité par la VRAM de sa carte. Le MacBook Air M4 est proposé à partir de 16 Go et le Mac Studio M3 Ultra peut être configuré avec jusqu’à 512 Go. La mémoire d’un Mac ne peut pas être augmentée après l’achat : il faut viser large dès la commande.
Le mini-PC
Les mini-PC équipés du processeur AMD Ryzen AI Max+ 395 reprennent la logique du Mac, avec jusqu’à 128 Go de mémoire partagée avec le GPU intégré. AMD indique qu’ils chargent gpt-oss-120b, dont les poids occupent environ 61 Go. Les mini-PC d’entrée de gamme, sans GPU performant, restent limités aux petits modèles.
Les limites à connaître avant d’acheter
Un modèle de 8 ou 20 milliards de paramètres reste moins performant que les modèles de pointe servis en ligne. Il commet plus d’erreurs de raisonnement, connaît moins de faits récents et n’effectue par défaut aucune recherche sur Internet. Pour un résumé, une reformulation, un brouillon d’e-mail ou de l’aide au code, il donne satisfaction. Pour une analyse longue et pointue, les assistants en ligne gardent l’avantage.
La consommation électrique varie énormément d’une famille à l’autre. Nvidia annonce jusqu’à 575 W pour la seule RTX 5090. Apple mesure 4 W au repos et 65 W au maximum pour un Mac mini M4 de 16 Go. Pour un usage de plusieurs heures par jour, cet écart modifie nettement la facture d’électricité.
Avant de télécharger un modèle, vérifiez aussi sa licence : celles de Llama, de Mistral, de Qwen ou de gpt-oss n’imposent pas les mêmes conditions d’usage commercial. Pour démarrer, un PC avec 16 Go de VRAM ou un Mac de 24 à 32 Go de mémoire unifiée couvre la plupart des usages courants.
Photo de couverture : FreeMediaKid!, Wikimedia Commons, licence CC BY-SA 4.0.

Michel, dirigeant d’une PME informatique et formateur, expert en logiciels professionnels tels que CRM et ERP. Sa connaissance approfondie des outils de gestion d’entreprise lui permettant de conseiller et former efficacement d’autres sociétés à leur utilisation.